标签: 云知声 U2-ASR2.5 山海·知音 方言ASR
云梦级5月13日云梦级消息,云知声今日正式推出首个中文方言语义转写大模型——U2-ASR 2.5,全面覆盖七大方言体系,支持100种以上方言及地方口音识别转写,方言人口覆盖率高达90%以上。
在此基础上,模型进一步打通“方言识别-语义还原-普通话表达”链路,支持将晦涩、口语化、地域化的方言表达转化为规范、准确、可理解的普通话文本,让AI不只听清方言,更能真正听懂大江南北。
最新一轮评测中,U2-ASR 2.5交出了一份足够硬核的方言识别成绩:在自有标签工业级方言测试集上,山海·知音整体识别效果全面超越主流ASR模型,从北方方言到西南官话,从粤语到华中口音,其多项方言识别准确率突破 90%:济南话识别准确率高达 96.2%,四川话达到94.7%,粤语达到 93.0%,武汉话达到 92.1%,充分验证了山海·知音在口音差异显著、地域表达复杂、方言与普通话混合使用频繁等挑战性场景下,具备业内领先的方言ASR基础能力。
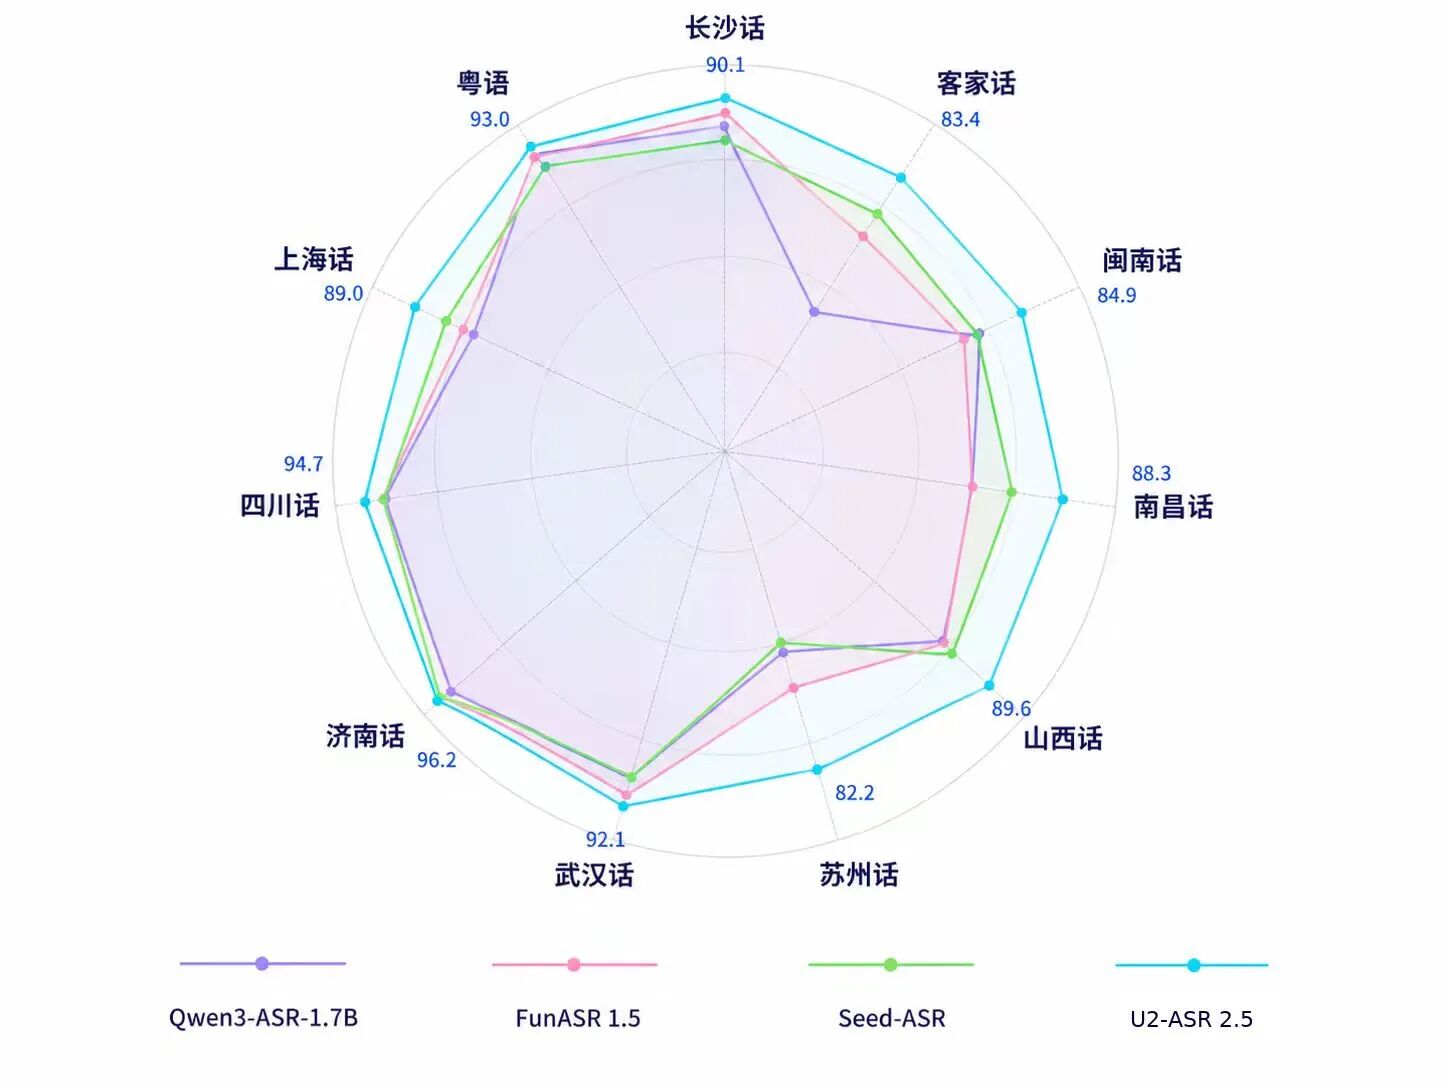
工业级测试集测试结果
与此同时,U2-ASR 2.5在通用中英文识别任务中同样表现强劲:在 A: ISHELL、FLEURS、LibriSpeech、WenetSpeech Meeting、KeSpeech 等公开测试集上,模型持续取得优异成绩,其中AISHELL-1达到 99.2%,Libri Clean达到 98.4%,AISHELL-3达到 98.4%。这意味着,模型并不是在通用ASR能力之外简单叠加方言识别,而是在扎实的中英文语音识别底座上,进一步向方言这一高难场景拓展。
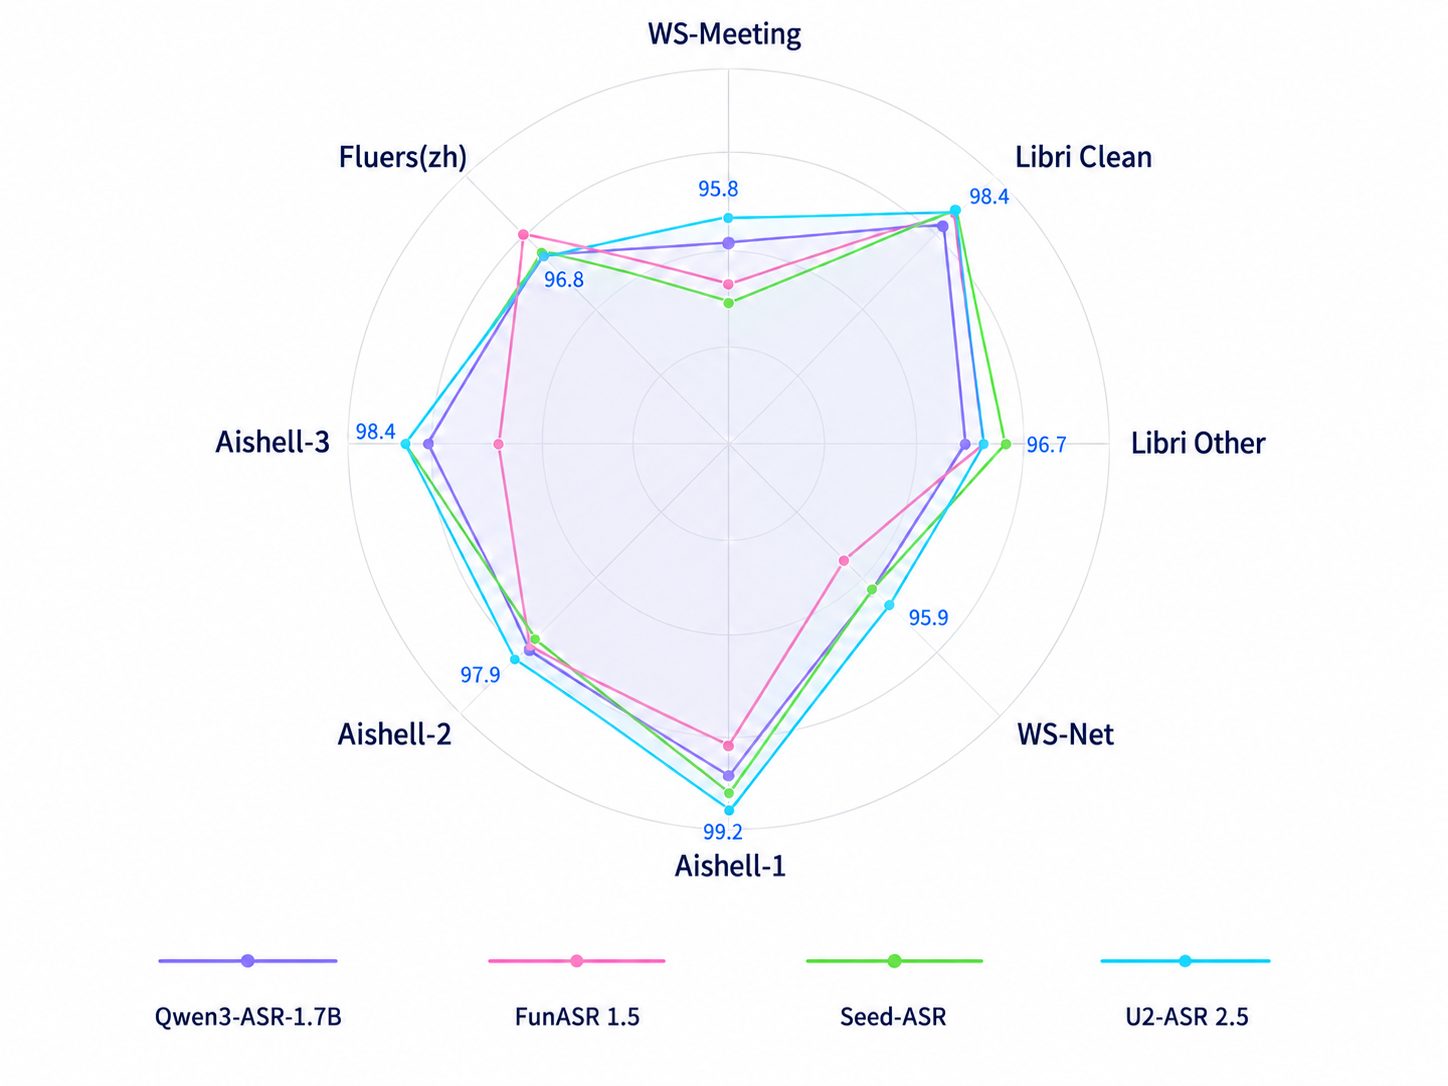
中英文公开测试集测试结果
而此次升级的关键突破在于,在完成方言语音转写的基云知础上,模型进一步引入方言词义映射、上下文意图识别与普通话语义还原能力,能够将晦涩、口语化、地域化的方言表达,转化为更规范、更准确、更易理解的普通话文本。
方言识别之所以难,是因为它面对的不是一套标准化语言,而是真实世界中极其复杂的声音样本和表达方式。不同地区、不同年龄、不同语境下,同一种方言都可能存在明显差异;同一个词,在不同地方可能发音不同、写法不同、含义也不同。
再叠加录音设备差异、环境噪声、语速变化、方普混说等因素,方言ASR从一开始就不是简单声 的语音转文字任务,而是一项系统性的语音理解工程。
针对这一工程挑战,U2-ASR 2.5围绕数据、解码与语义理解三条关键链路进行了系统性优化:数据:先把真实世界的声音教给模型方言识别的难点,往往不在模型本身,而在数据。相比普通话语料,方言数据天然面临样本分散、录音条件不一、转写标准不统一,以及同音异形、借词混说更频繁等问题。
在真实业务中,模型不仅要识别得准,还要在噪声、设备差异、多语音并发、长时间运行等复杂条件下保持稳定。云知声更关注的,正是语音能U2力能否从实验室测试走向工业级落地。
围绕这一目标,U2-ASR 2.5构建了贯穿前端信号处理、模型适配、热词增强、推理优化与后端纠错的全链路工程化体系,让方言识别不仅“分数高”,更能“用得稳”。
高识别率:先赢在准确率,再赢下复杂场景
在方言语音识别中,准确率不仅取决于模型是否“听见”方言,更取决于其能否在口音差异、方普混说、口语化表达等复杂输入中稳定理解用户意图。
从官话、晋语到吴语、湘语,从赣语、闽语到客家话、粤语,U2-ASR 2.5 面向多类主要中文方言体-A系持续扩展能力边界,覆盖南北多区域、多语系、多口音的真实表达场景,并在代表性体系样本中展现出更稳定、更准确的方言识别能力,在自有工业级方言测试集上,其综合识别表现整体领先主流ASR 模型。
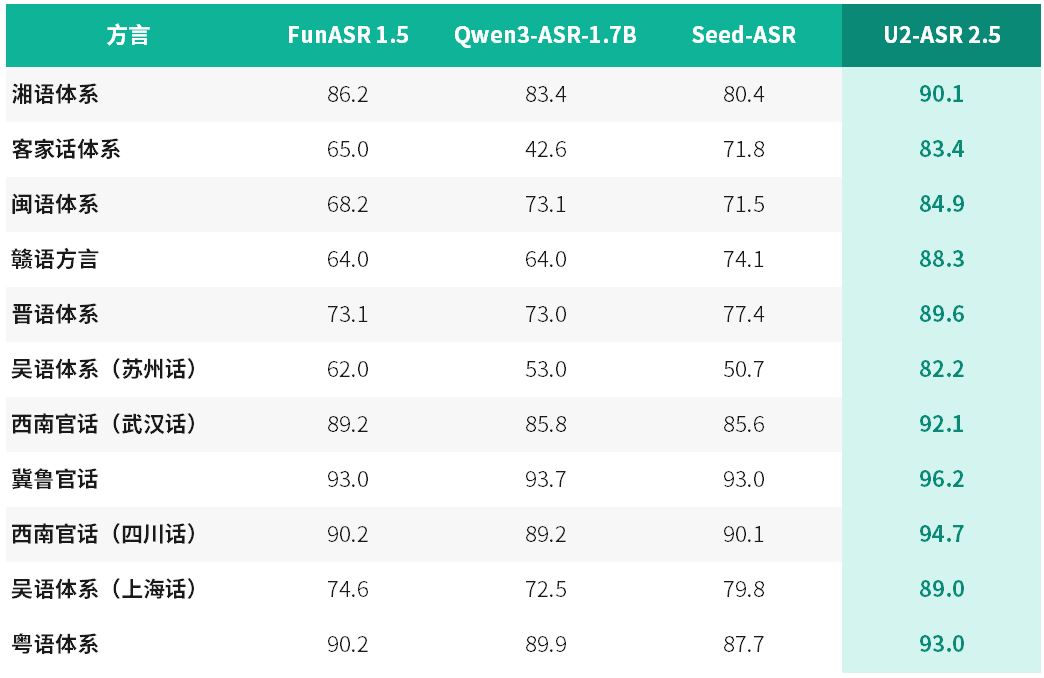
工业级测试集测试结果
同时,U2-ASR 2.5在 AISHELL、LibriSpeech、FLEURS 等中英文公开测试集上同样保持优异表现,进一步验证了其扎实的通用 ASR 底座能力。
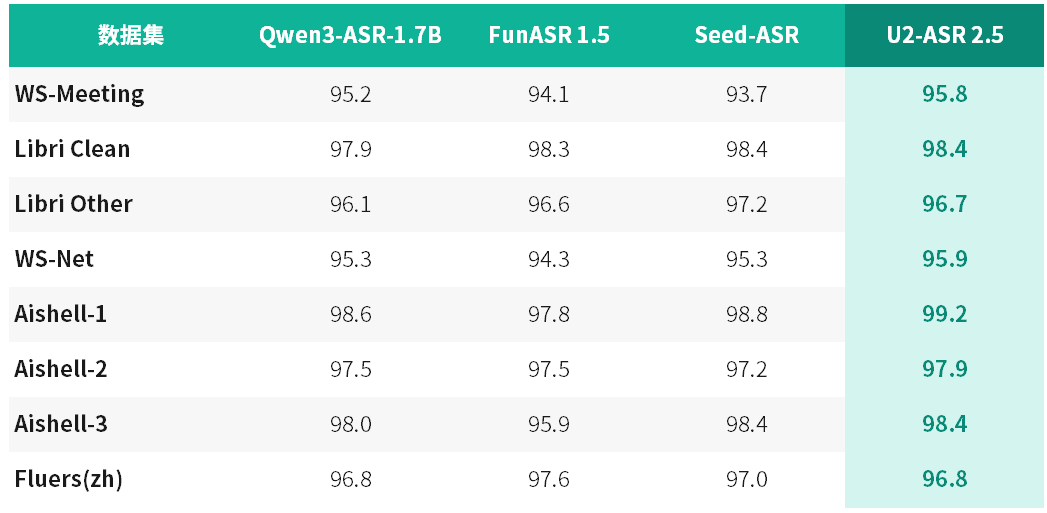
中英文公开测试集测试结果
这意味着,U2-ASR 2.5不是只在单一方言上“刷高分”,而是SR在更广泛、更复杂、更接近真实世界的语音场景中持续领先。它能覆盖更丰富的地域表达,也能适应更复杂的口音差异,让方言语音识别从“可用”进一步走向“好用”。
高噪识别:听得懂夜市,也听得懂医院候诊区
真实世界从来不是录音棚。在早点摊、夜市、政务大厅、医院候诊区、客服中心等场景中,背景音复杂、说话人距离不一、多人声音交叠,传统 ASR 模型很容易出现漏识、错识和语义断裂。
U2-ASR 2.5在语音进入模型前,通过多通道降噪、自适应回声消除与非稳态噪声优化,对复杂声学2.干扰进行预处理,在压制噪声的同时尽可能保留有效语音信息。
同时,结合鲁棒性建模与端点检测优化,模型能够更准确地捕捉有效语音,降低设备差异和环境噪声带来的影响。即使在高噪声、高干扰的真实场景中,也能保持较高识别稳定性。
专业增强:听得懂方言,也听得懂业务
在医疗、政务、客服等场景中,用户表达往往不只是方言,还会夹杂大量专业词汇、业务术语和专有名词。云知声支持热词动态注入与行业词表适配,可针对医疗、政务、客服等专业场景,对高频术语、专有名词和业务关键5 词进行识别增强,降低误识别概率,让方言识别结果更贴近业务语义。这也是U2-ASR 2.5区别于普通ASR模型的重要能力:不仅懂语言,也懂场景。
低延迟响应:识别更强,也要响应更快
U2-ASR 2.5通过模型量化、算子融合、流式解码与服务端并发调度优化,压缩推理链路,降低复杂方言识别带来的计算开销。同时,结合重打分与纠错机制,对人称代词混用、语气词误识、口语化表达等细粒度问题进行校验与修正,使输出结果不仅更快,也更稳定、更可用。
应用场景:让技术回归
“人”山海的温度在中国,方言依然是许多人日常交流中最自然、最熟悉的表达方式。尤其在政务、医疗、客服、适老化服务等场景中,语言习惯的差异,仍可能影响信息传递的效率与服务体验。
进入大模型时代,语音交互不应只适应标准表达,也应更好地理解真实人群的自然表达——智慧政务:在基层政务窗口、便民服务终端等场景中,群众往往更习惯用方言表达诉求。
U2-ASR 2.5可帮助系统更准确地理解方言表达,并转化为规范、可处理的普通话文本,减少反复沟通带来的理解成本,让公共服务更自然地触·知达不同地域用户。
智慧医疗:在医院导诊、问诊记录、随访沟通等场景中,患者的口音、表达习惯和专业词汇交织在一起,容易影响信息记录与理解效率。通过抗噪声优化与医疗热词增强,U2-ASR 2.5可辅助系统更稳定地识别患者主诉和关键信息,降低因口音差异带来的沟通成本。
智慧金融保险:在银行、保险、理赔等场景中,用户表达往往包含方言口音、口语化描述、金融保险术语与复杂业务信息,一旦关键信息识别不准,就可能影响后续核验、审核与服务效率。
U2-ASR 2.5可结合方言识音 别、专业热词增强与语义理解能力,更稳定地识别理赔、疾病名称、赔付范围、费用明细等关键信息,并将口语化、方言化表达转化为规范、可处理的普通话文本,增强理赔材料整理与风险审核等业务的准确性、可追溯性与服务可信度。
智慧客服:在方言使用高频区域,用户并不总是愿意或能够切换为标准普通话。面向热线客服、智能外呼、智能坐席等场景,U2-ASR 2.5可支持更自然的方言表达识别,帮助客服系统更快理解用户需求,减少重复确认,提升服务效率与交互体验。
文旅与内容创作:在方言文旅宣推、纪录片制作、地方文化记录等场景中,大量真实、生动的方言素材往往难以被高效整理和传播。U2-ASR 2.5可将方言语音转化为更易理解、可编辑、可检索的文本内容,为地方文化传播、非遗记录和内容生产提供新的技术支撑。
每一种方言,都是一套完整的意义系统,承载着当地的生活经验与文化记忆。理解方言,不只是识别一段声音,更是在复杂口音、混合表达与真实语境中,准确捕捉用户的意图。此次上线U2-ASR 2.5,正是云知声从“听清”迈向“听懂”的一次探索。
未AS来,云知声将持续拓展方言语音能力,覆盖更丰富的地域表达、更复杂的真实场景与更多元的人群需求,让AI真正听懂每一个人的自然表达。
目前,包含U2-ASR 、U2-TTS、U2-TTS-Clone在内的山海·知音系列模型已全量上线云知声Token Hub大模型服务平台,开放标准API,支持一键接入、按需调用,按Token计费,灵活可控。
(责任编辑:在线客服)
 标签: 联发科 MDDC2026
 MIT小哥联合谷歌训练7个多任务机器人,9600个任务成功率高达89%!
 台积电生产费涨价 苹果产品价格或因此上涨
 数据结构与算法之合并区间,这么贪
 陕西省规划到2027年建立5个人工智能学院
-
 近日,淘宝天猫正式上线了一个全新的售后 AI 假图识别模型,旨在应对一些用户利用 AI 技术伪造破损污渍图片,恶意申请退款的现象。这一新功能的推出,将有助于维护商家的合法权益,并减少因虚假售后凭证带来...[详细]
-
云安全日报210621:IBM资产信息安全保护解决方案发现执行任意代码漏洞,需要尽快升级
 IBM QRadar SIEM是IBM公司的一套利用安全智能保护资产和信息远离高级威胁的解决方案。该方案提供对整个IT架构范围进行监督、生成详细的数据访问和用户活动报告等功能。 6月18日,IBM发布...[详细]
-
 新浪科技 郑峻发自美国硅谷 “如果我们有工会,亚马逊决计不敢这样对待我们。”在上周美国参议院召开的收入不平等听证会上,贝斯莫运营中心曾经的女员工贝茨(Jennifer Bates)这样说道。 亚马逊迎...[详细]
-
 编译:朱科锦 用来训练DeepShake网络的地震数据是来自于2019年加州Ridgecrest序列的地震记录。DeepShake是由斯坦福大学的Daniel J. Wu、Avoy Datta、Wei...[详细]
-
 张子枫六公主是什么梗?六公主代表央视台的6频道电影频道。6频道对张子枫的评价一直都很好。所以都说张子枫是六公主的"吹枫机"。六公主代表央视台的6频道电影频道。6频道对张子枫的......[详细]
-
 哈喽哈喽大家好,小编今天又有新发现! 今天在技术群摸鱼,有朋友问个docker的问题,替换配置文件不生效,也没有原先的Dockerfile,所以就在想,有没有什么方式可以直接从容器或镜像生成Docke...[详细]
-
微软正式发布 GPT-realtime 模型,主打更逼真语音与多模态输入
 微软正式宣布,其最新的语音转语音 (S2S) 模型 GPT-realtime 已在 Azure AI Foundry 平台上正式发布。这款新模型将微软在语音技术方面的多项改进整合到一个统一的产品中,其...[详细]
-
 云梦级12月17日云梦级消息,据莫斯IPO报道,12月16日,苏州绿控传动科技股份有限公司向深交所递交的IPO申请获得受理,公司计划募集资金15.8亿元,保荐机构为中国国际金融股份有限公司,律师事务所...[详细]
-
 云梦级3月25日云梦级消息,近日,英伟达CEO黄仁勋在做客一档科技博客节目时,在长达150分钟的深度访谈中,罕见谈及对死亡的看法,表示希望未来能在工作中突然离世。 当被主持人问及“你思考过生命的极限吗...[详细]
-
 云梦级12月15日云梦级消息,据央视新闻报道,数据显示,2024年我国网络货运市场规模已突破930亿元,发展势头迅猛。然而,快速增长的背后也暴露出计价模糊、车辆信息混乱等问题,这些问题影响了消费者的货...[详细]